Mistral libera os pesos do seu modelo de 1 trilhão de parâmetros
A Mistral AI liberou os pesos do Mistral Large 4, um modelo multimodal de 1 trilhão de parâmetros, para que qualquer pessoa possa baixá-lo, rodá-lo em seus próprios servidores e ajustá-lo com refinamento fino. Os pesos são gratuitos sob uma licença MIT modificada, com uma ressalva: empresas que vendem o modelo como serviço hospedado precisam de uma licença separada da Mistral. Quem preferir não rodá-lo pode usar a API da Mistral, que cobra US$ 0,70 por milhão de tokens de entrada e US$ 2,10 por milhão de tokens de saída. A empresa francesa, que apelidou o modelo de "Le Chonk", afirma que ele é o melhor modelo de pesos abertos para programação.
O Large 4 foi lançado pela primeira vez em prévia pública no início deste mês. A Mistral diz que, desde então, passou mais três semanas em aprendizado por reforço, e que os ganhos em programação e segurança defensiva não perderam força.
A Mistral também ressalta que treinou o modelo do zero em infraestrutura europeia. Isso significa que o treinamento rodou em servidores na Europa e que a própria Mistral construiu o modelo, em vez de partir do de outra empresa. O anúncio não nomeia os data centers nem o hardware. Isso importa para os clientes da Mistral por causa de seu discurso de "IA soberana": um cliente deve possuir e controlar a IA da qual depende. Para um banco ou uma agência europeia, isso significa saber onde ficam seus dados e sua computação, qual legislação de qual país se aplica e que nada na história do modelo depende de um fornecedor dos EUA ou da China. A Mistral afirma que pesos abertos e treinamento europeu são o caminho para entregar isso.
A afirmação mais forte da Mistral está na programação: no teste privado FrontierCode 2.0, da Cognition, que pergunta se um mantenedor de repositório aprovaria a mudança feita pelo agente, o Large 4 marcou 19,7%. Essa é a maior nota entre os modelos abertos que a Mistral comparou.
No Artificial Analysis Coding Agent Index, o modelo marcou 48%, praticamente empatado com o líder GLM-5.3, usando 47% menos tokens por tarefa. Menos tokens significam um agente mais barato em escala.
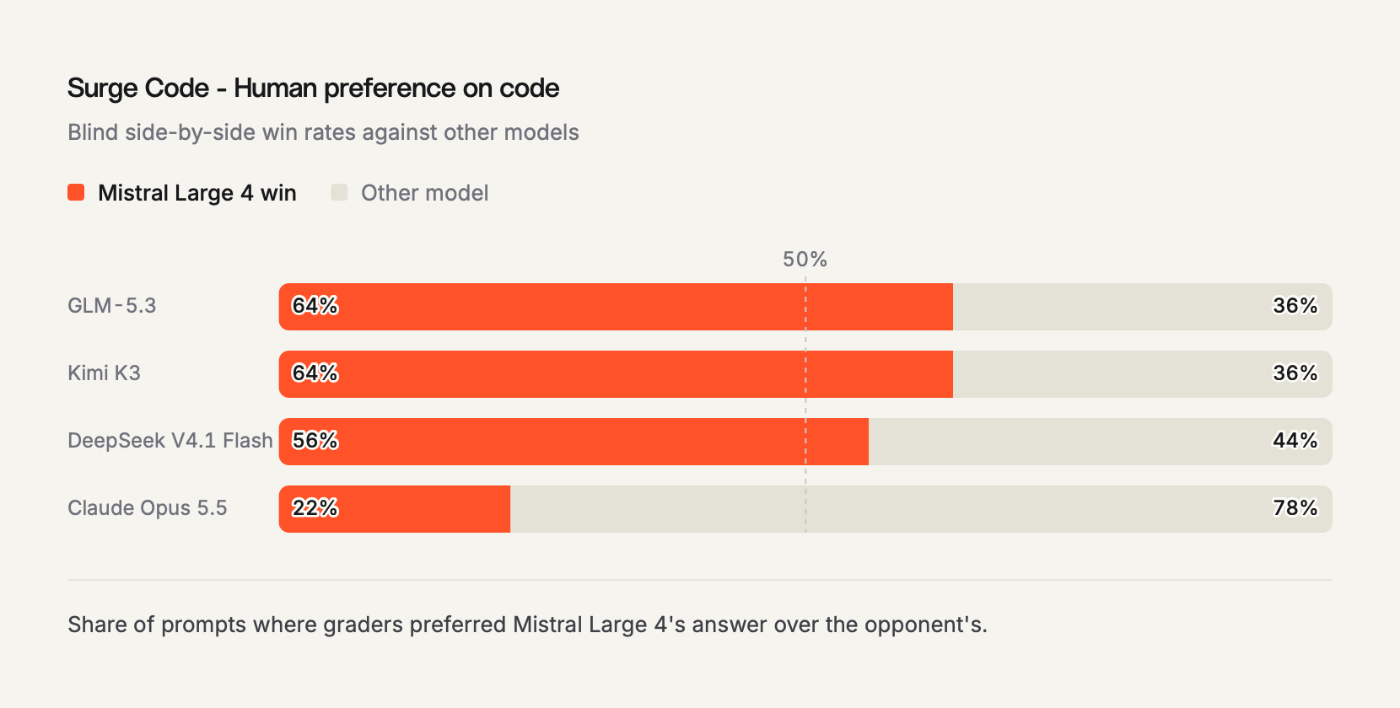
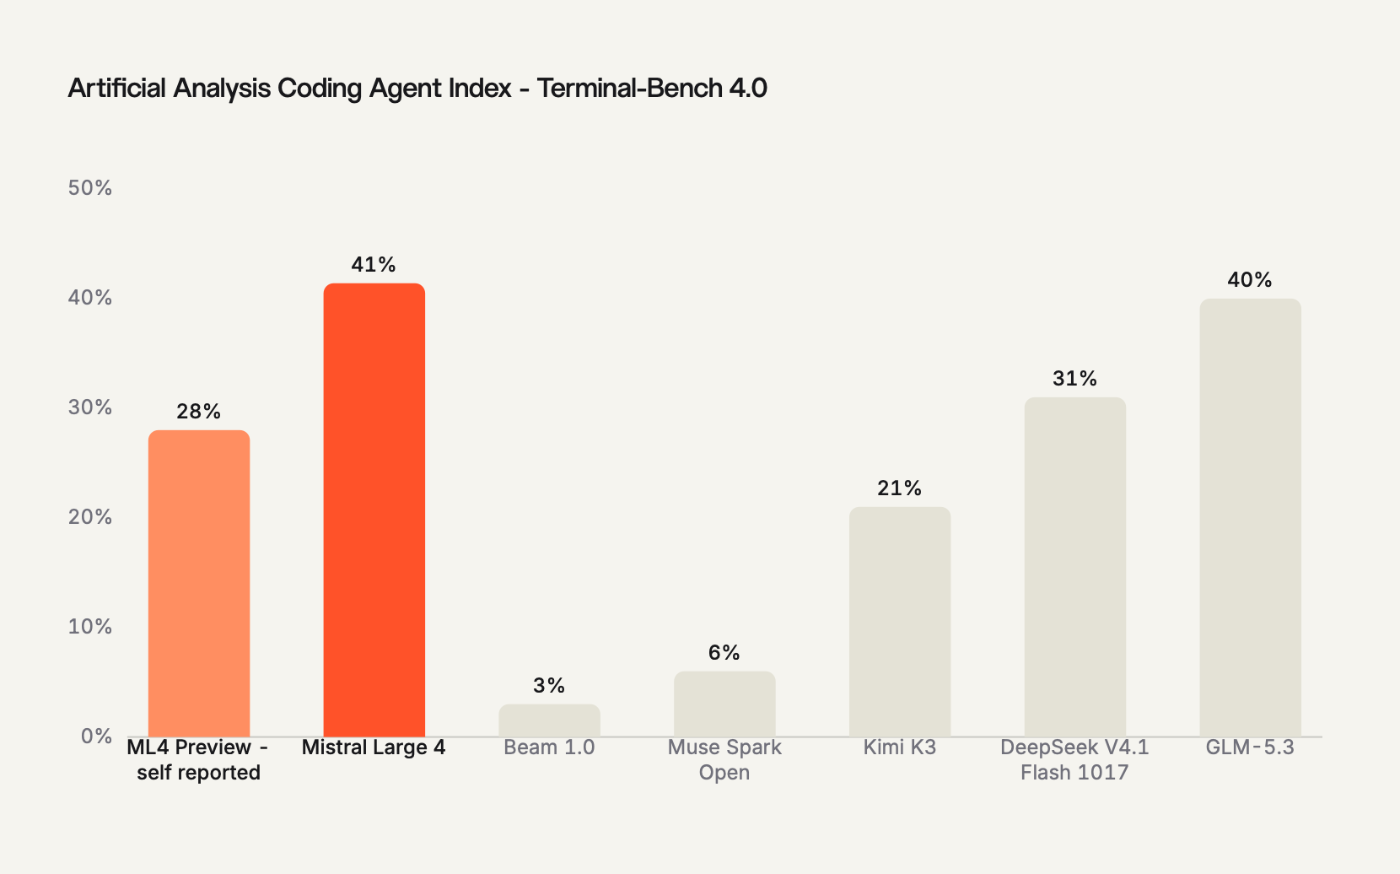
No Terminal-Bench 4.0 ele chegou a 41%, 13 pontos acima da prévia, com 30% menos tokens de saída. Em testes cegos lado a lado conduzidos pela Surge Code, avaliadores preferiram o Large 4 ao GLM-5.3, ao Kimi K3 e ao DeepSeek V4.1 Flash. Apenas o Claude Opus 5.5 ficou à frente, vencendo-o em 78% dos prompts comparados.
A Mistral também aposta forte em segurança com seu novo modelo: o Large 4 marcou 51% no Artificial Analysis Cyber Index, que testa se um modelo consegue encontrar uma vulnerabilidade, reproduzi-la e corrigi-la sem quebrar o código. A Mistral diz que faz esse trabalho sem recusas desnecessárias. Seu próprio gráfico mostra vários rivais com notas maiores, incluindo o DeepSeek V4.1 Flash, com 57%.
A empresa afirma que o modelo recusa 96,6% das solicitações cibernéticas maliciosas, a maior taxa que mediu entre modelos abertos. Mas a Mistral também admite algo que a maioria dos fornecedores evita. Ao monitorar o tráfego real desde a prévia, viu o modelo recusar ataques de caixa-preta contra alvos reais, mas identificou potencial para ampliar a capacidade de ataques reais. A empresa está endurecendo as salvaguardas e continuará atualizando-as.
Isso pesa mais com pesos abertos. Quando a Mistral roda o modelo em seus próprios servidores, pode acompanhar como as pessoas o usam, interromper abusos e alterar as regras de segurança a qualquer momento. Quando um modelo é baixado, a Mistral não consegue ver o que acontece com ele, e um usuário determinado poderia retreiná-lo para remover as salvaguardas.
A Mistral trata esse risco com uma versão mais robusta, criada para testes de penetração e red-teaming, ou seja, ataques simulados que encontram falhas nas defesas de uma empresa. Ela só é disponibilizada a parceiros verificados, como a Orange Cyberdefense, sob contrato, e apenas para sistemas que eles possuem ou estão autorizados a testar.
Duas perguntas importam mais daqui em diante: a primeira é se avaliações externas confirmam as afirmações sobre programação e eficiência de tokens. Agora que os pesos são públicos, equipes independentes podem fazer seus próprios testes e verificá-las. A segunda é como as salvaguardas se sustentam quando os pesos estiverem soltos. A Mistral diz que o modelo recusa 96,6% das solicitações cibernéticas maliciosas, mas também reconheceu um potencial de ampliação de ataques reais e está mudando suas salvaguardas.
© Raydn · raydn.us