Mistral开放1万亿参数模型权重
Mistral AI已发布Mistral Large 4的权重。这是一款1万亿参数的多模态模型,任何人都可以下载、在自有服务器上运行并进行微调。权重依据修改版MIT许可证免费提供,但有一个限制:将该模型作为托管服务出售的公司,需要另行获得Mistral的许可。不想自行运行模型的用户,可以使用Mistral的API,其收费为每百万输入token 0.70美元,每百万输出token 2.10美元。这家法国公司将该模型昵称为“Le Chonk”,并称它是目前编程能力最强的开放权重模型。
Large 4于本月早些时候以公开预览版首次推出。Mistral称,此后它又用三周时间进行强化学习,并表示编程和防御性安全方面的能力提升尚未放缓。
Mistral还强调,该模型是在欧洲基础设施上从零开始训练的。这意味着训练运行于欧洲的服务器上,且模型由Mistral自行构建,而非以其他公司的模型为起点。公告未提及数据中心或硬件。这对Mistral的客户而言意义重大,因为该公司主打“主权AI”:客户应当拥有并掌控其所依赖的AI。对欧洲银行或政府机构来说,这意味着清楚知道其数据和算力位于何处,适用哪国法律,以及模型的来源中不依赖任何美国或中国的供应商。Mistral表示,开放权重和欧洲训练正是其实现这一目标的途径。
Mistral最有力的主张体现在编程方面:在Cognition的私有测试FrontierCode 2.0中,该测试考察代码仓库维护者是否会合并智能体的改动,Large 4得分为19.7%,是Mistral所统计的开放模型中的最高分。
在Artificial Analysis编程智能体指数上,它得分为48%,与领先者GLM-5.3基本持平,同时每项任务少用47%的token。token用量更少,意味着大规模部署智能体的成本更低。
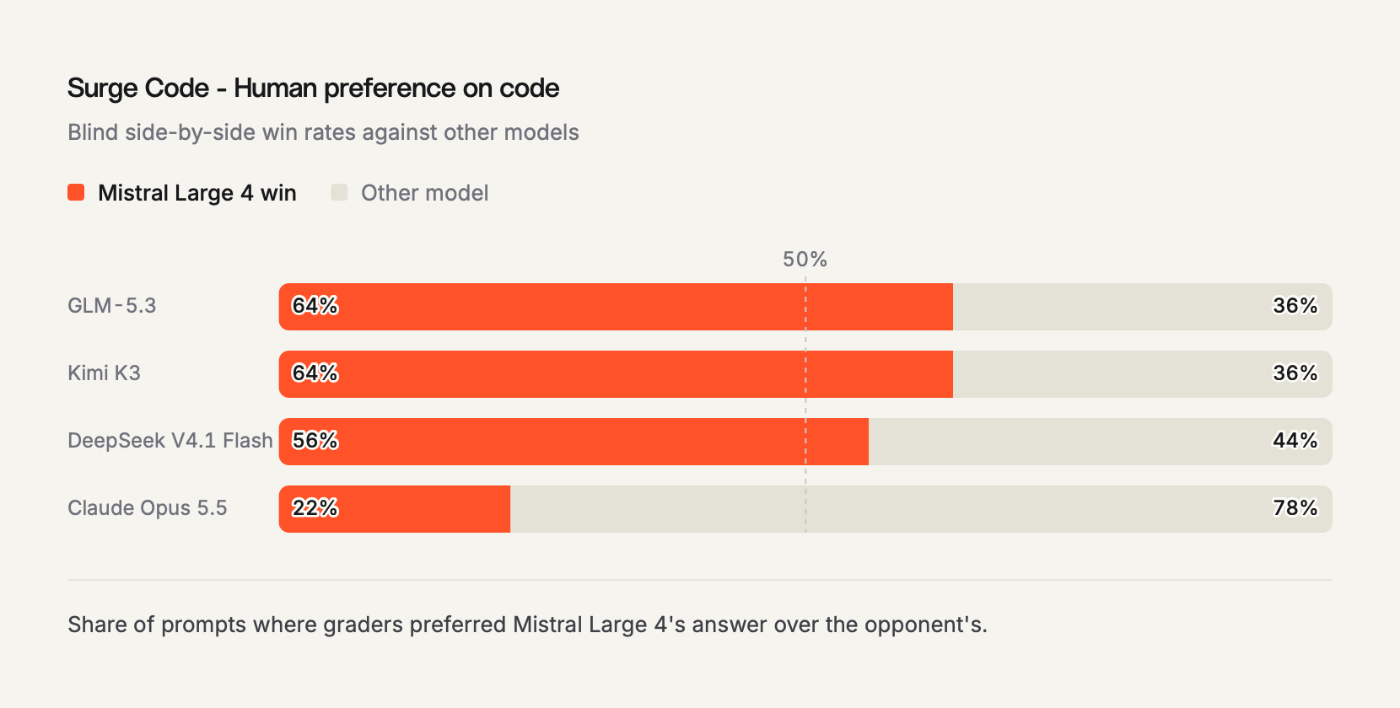
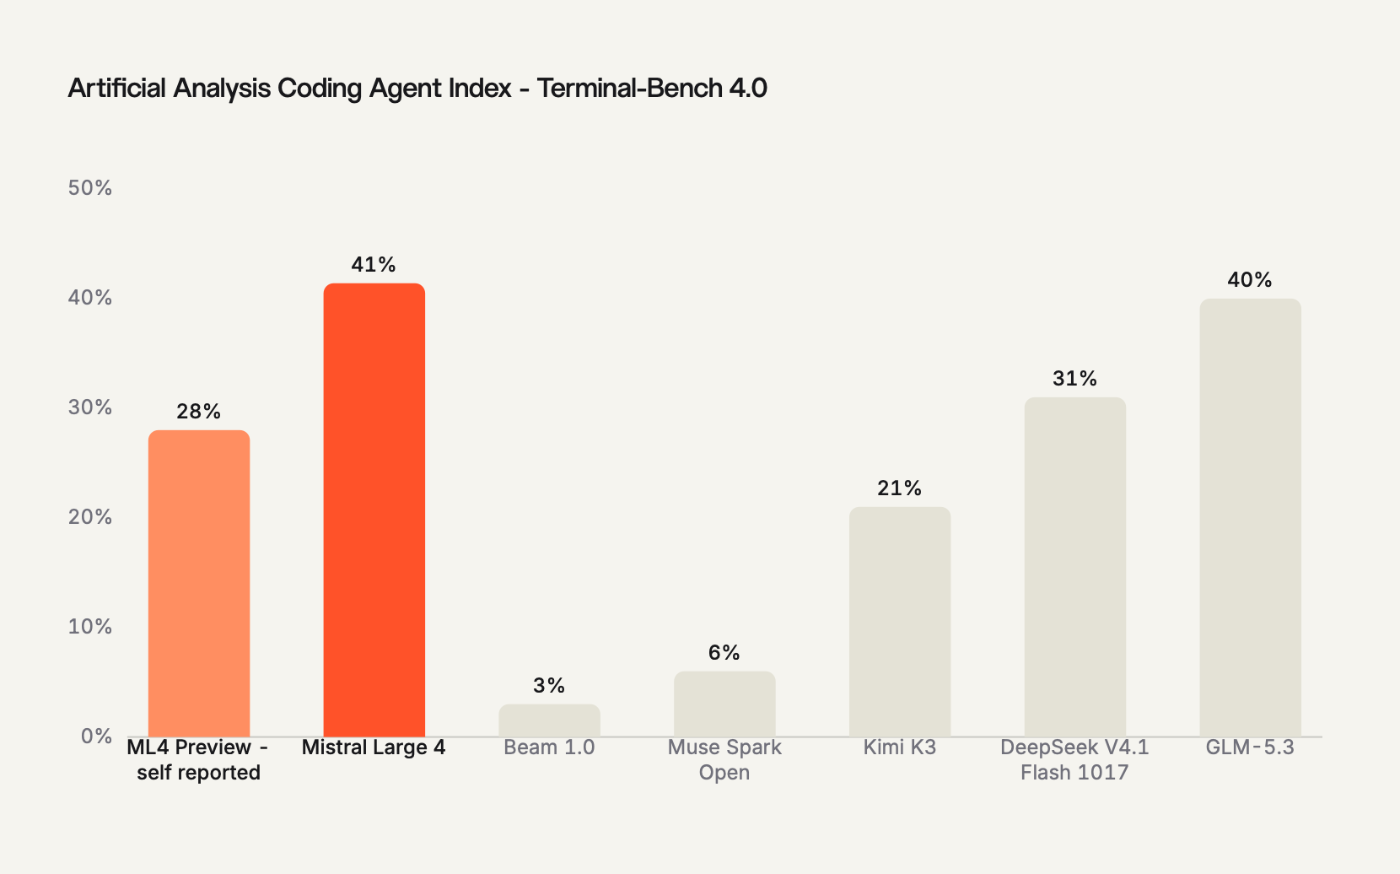
在Terminal-Bench 4.0上,它达到41%,较预览版提升13个百分点,输出token减少30%。在Surge Code进行的盲测并排对比中,评分者更倾向于Large 4,而非GLM-5.3、Kimi K3和DeepSeek V4.1 Flash。仅有Claude Opus 5.5排在其之前,在所比较的提示词中,它在78%的情况下胜过Large 4。
Mistral还在新模型的安全性上着力甚多:Large 4在Artificial Analysis网络安全指数上得分为51%,该指数测试模型能否发现漏洞、复现漏洞并在不破坏代码的前提下修补。Mistral称,其模型在执行这类任务时不会进行不必要的拒绝。但其自己的图表显示,多个竞争对手得分更高,其中DeepSeek V4.1 Flash为57%。
该公司称,模型拒绝了96.6%的恶意网络安全请求,这是其所测开放模型中的最高比例。但Mistral也承认了多数厂商会回避的一点:自预览版推出以来,它监测实时流量,发现模型曾拒绝针对真实目标的黑盒攻击,但仍认为它存在提升真实攻击能力的可能。目前该公司正在收紧防护措施,并将持续更新。
开放权重使这一风险更为突出。当Mistral在自有服务器上运行模型时,它可以观察用户如何使用,制止滥用,并随时调整安全规则。模型一旦被下载,Mistral便无从得知其后续去向,而执意的用户可以对其重新训练,移除安全保护措施。
对于这一风险,Mistral以一个更强的版本加以应对,该版本专为渗透测试和红队演练而打造,即模拟攻击,用以发现企业防御中的漏洞。该版本仅提供给经过审核的合作伙伴,例如Orange Cyberdefense,须签订合同,且只能用于其拥有或获得授权测试的系统。
此后有两个问题最为关键。第一,外部评估能否证实其在编程和token效率方面的主张。既然权重已经公开,独立团队便可自行测试加以核实。第二,一旦权重流入外界,防护措施能否经受住考验。Mistral称模型拒绝了96.6%的恶意网络安全请求,但它也指出模型存在提升真实攻击能力的可能,并正在调整其防护措施。
© Raydn · raydn.us