RSI chegou: a IA da Anthropic agora está acelerando a IA da Anthropic
A METR afirma que a pesquisa assistida por IA no laboratório de fronteira provavelmente dobrou o ritmo do progresso medido, com a maior parte do efeito vindo, provavelmente, da própria IA.
Durante onze semanas neste outono, uma pequena equipe da METR, um grupo independente de avaliação de IA, trabalhou dentro da Anthropic para responder a uma pergunta: quanto a IA está acelerando o trabalho de construir IA? A resposta deles, publicada hoje, é que ela já está acelerando, e muito. A equipe da METR estima que, em outubro de 2026, a Anthropic está melhorando seus modelos em tarefas bem especificadas a cerca de duas vezes o ritmo que alcançou entre março de 2024 e outubro de 2025.
O número principal vem do AECI, a versão da Anthropic do Epoch Capabilities Index mostrado abaixo, que pontua modelos em um conjunto de benchmarks. Antes de outubro de 2025, os modelos da Anthropic ganhavam cerca de 15 pontos de AECI por ano. Desde então, a tendência se acentuou para cerca de 29 pontos por ano. Isso representa uma aceleração de 1,9x, com um intervalo de confiança de 95% entre 1,5x e 2,8x, o que significa que a Anthropic fez cerca de dois anos de progresso histórico nos últimos doze meses.
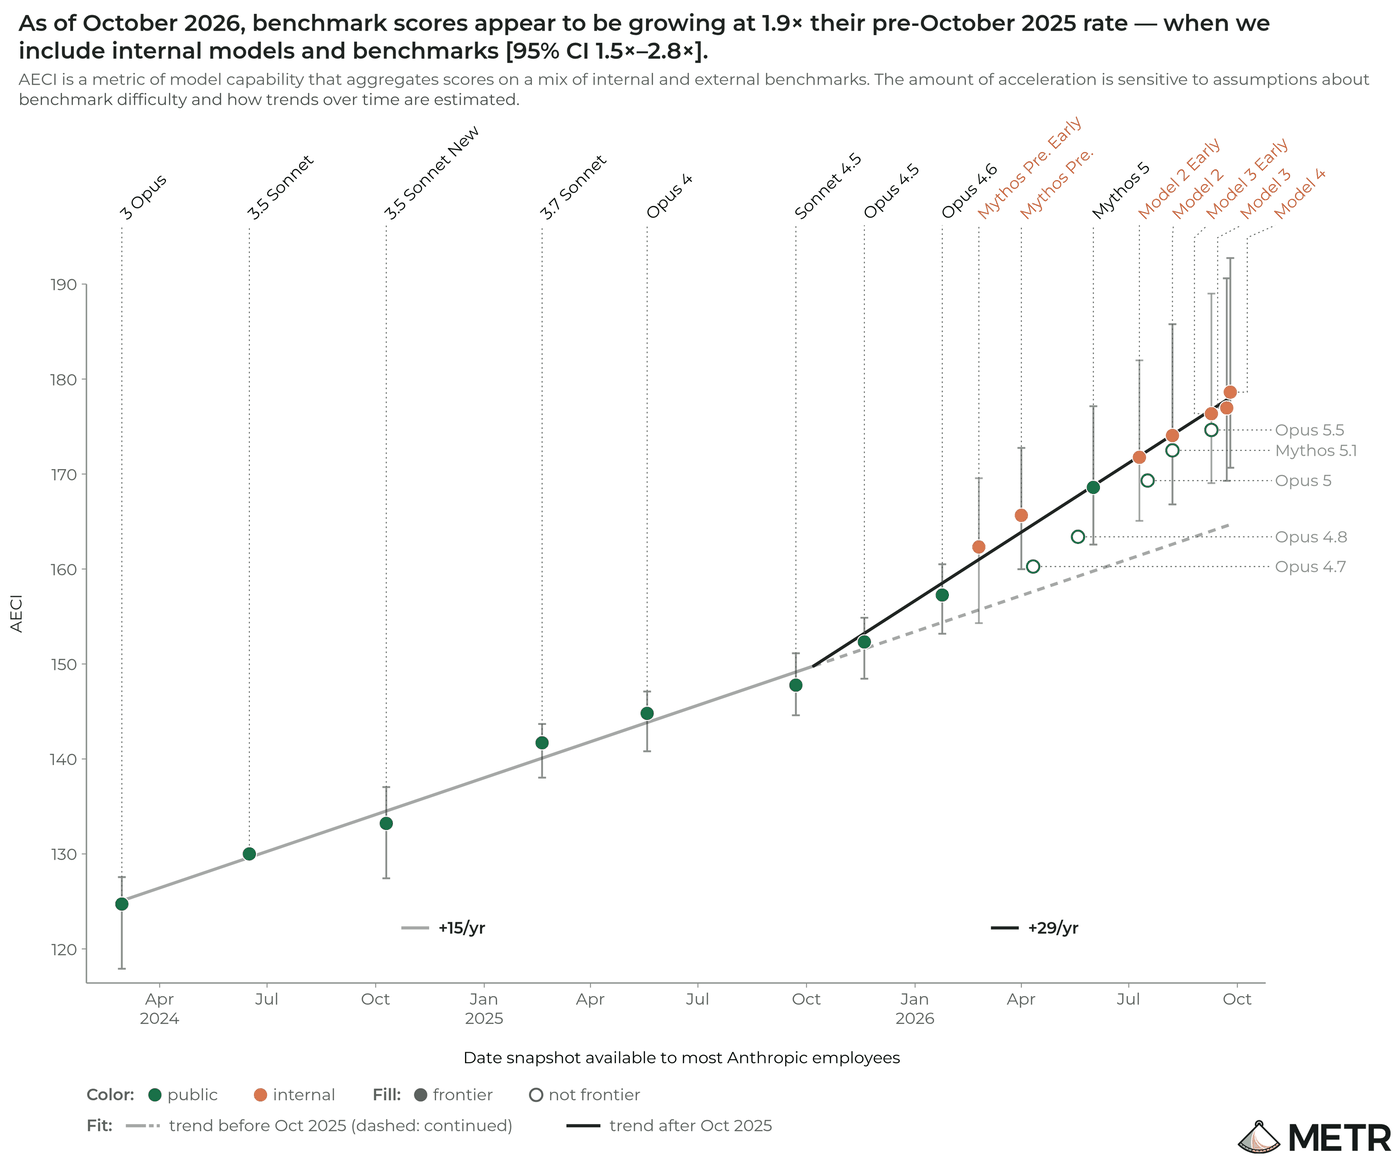
A estimativa muda com o método. Diferentes premissas sobre como a dificuldade dos benchmarks se distribui produzem resultados que vão de 1,1x a 2,9x. Incluir modelos da OpenAI, do Google e da xAI reduz o número para 1,4x, em parte porque os modelos anteriores da Anthropic ficavam atrás da fronteira da indústria, o que faz a própria história dela parecer mais lenta do que foi. A METR diz que o principal motivo para seu número superar o 1,7x publicado pela Anthropic é a inclusão de modelos internos recentes, que não foram lançados.
A METR afirma estar confiante de que a aceleração não veio de um crescimento mais rápido do poder computacional de treinamento, e o palpite da METR é que cerca de 80% da aceleração atual se deve à IA, com a ressalva de que fatores não relacionados à IA provavelmente tiveram papel no salto do fim de 2025. As evidências de apoio são frágeis, mas consistentes. Em entrevistas, pesquisadores descreveram ganhos de velocidade concentrados em torno de 2x, e, dos onze entrevistados cujas respostas puderam ser codificadas, cinco disseram sim ou tenderam para sim em 2x ou mais, quatro ficaram indefinidos e dois disseram não. Em enquetes informais no Slack, a equipe avaliou o modelo interno mais novo com um ganho de cerca de 12x, ante aproximadamente 1,2x do Claude 3.7 Sonnet. A METR trata isso como evidência frouxa, já que as respostas foram dadas com pouco esforço e podem exagerar os ganhos reais. Ela também destaca uma distinção essencial: uma pessoa ser 12x mais rápida não significa que todo o esforço de pesquisa esteja acelerando 12x. Uma aceleração sustentada da produção exige crescimento sustentado de insumos como trabalho e produtividade do trabalho, então o que mais importa é se o ganho individual continua crescendo.
Isso leva ao risco que mais preocupa a METR, que é o efeito composto: se modelos melhores aceleram a pesquisa que produz os próximos modelos, os ganhos podem se alimentar de si mesmos. A METR buscou os fatores que normalmente quebrariam esse ciclo, como limites no progresso algorítmico, no poder computacional de treinamento, no poder computacional de experimentos ou nos dados, e não encontrou um gargalo convincente nos próximos 12 meses. A METR conclui que há um risco significativo de que mais progresso leve a uma aceleração ainda maior no próximo ano.
O relatório dedica espaço considerável a como poderia estar errado, nas duas direções:
O número poderia ser baixo demais se o crescimento estiver acelerando continuamente, se a automação estiver mais próxima do que os pesquisadores acreditam, ou se os benchmarks subestimarem o impacto no mundo real. A METR aponta para a matemática, em que as pontuações dos benchmarks não saltaram, mas problemas antigos estão agora sendo resolvidos.
Ele também poderia ser alto demais se fatores não relacionados à IA explicarem a maior parte do ganho, se os modelos da Anthropic estiverem superajustados a tarefas no estilo dos benchmarks, ou se a taxa histórica tiver sido excepcionalmente lenta.
Medir fica cada vez mais difícil. O modelo interno mais novo da Anthropic, o Model 4, atinge mais de 50% em todos os 15 benchmarks em que foi testado, o que torna mais difícil medir o próximo salto. A METR também observa que a Anthropic gasta menos tokens por tarefa de benchmark do que seria necessário para extrair plenamente as capacidades de um modelo, embora estime que isso afete modelos antigos e novos de forma semelhante.
Há, ainda, a questão do que o público pode efetivamente ver. A Anthropic deu à METR mais acesso do que o grupo esperava, incluindo dados internos de benchmarks, número de funcionários, código e informações sobre gastos com agentes, além de cerca de 15 entrevistas com a equipe. Mas a Anthropic manteve direitos unilaterais de redação e os usou intensamente. Medidas internas intermediárias, estimativas de progresso algorítmico, análise de gargalos, a divisão do progresso entre computação, dados e algoritmos, e previsões para modelos futuros foram todas removidas do relatório público. A Anthropic diz que as redações visavam remover informações que poderiam acelerar outros desenvolvedores. A METR afirma que grande parte do que viu admitia várias interpretações plausíveis, e que sua própria equipe e os pesquisadores da Anthropic discordam sobre como juntar as evidências. Isso deixa os leitores dependendo do julgamento da METR mais do que alguém gostaria. Uma verificação planejada de como a Anthropic divide a computação entre capacidades e segurança foi abandonada no meio do caminho. A Anthropic disse que queria manter o foco no risco e que voltaria ao tema mais tarde.
O relatório completo da METR está disponível aqui.
© Raydn · raydn.us